

简介:本项目利用Python构建了一个P2P网络,重点在于使用yamux实现的多路复用技术和自定义协议的支持。P2P网络是一种去中心化架构,其中节点既是服务的消费者也是提供者,具有高稳定性和可扩展性。yamux多路复用协议提高了通信效率,减少连接开销,而自定义协议则增强了网络的适用性和灵活性。项目涵盖了节点发现、连接管理、自定义协议设计、数据交换和错误处理等关键部分,适合希望提升Python网络编程技能的开发者研究和实践。
1. P2P网络原理
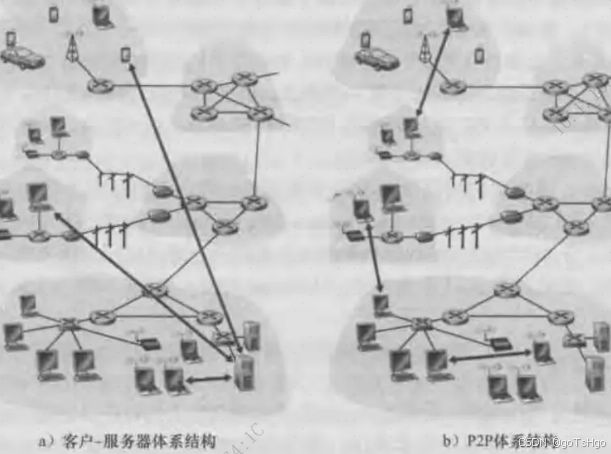
P2P(Peer-to-Peer)网络,也称为点对点网络,是一种去中心化的计算机网络形式,其中每个参与节点既可以充当客户端也可以充当服务器的角色。P2P网络中的每个节点都能直接与其他节点通信,共享资源和服务。
1.1 P2P网络的基本概念
P2P网络的核心是去中心化,这意味着没有集中式服务器或控制点,网络的稳定性和扩展性不会因为某个单一节点的失败而受到影响。在P2P网络中,资源(如数据、CPU周期、存储空间)由节点直接共享给其他节点。
1.2 P2P网络的结构
在P2P网络中,节点既是服务的消费者也是服务的提供者。节点通常通过网络发现机制相互定位,并建立直接的连接进行数据交换。P2P网络架构可分为纯P2P网络、混合P2P网络和中心化P2P网络三种。
1.3 P2P网络的工作原理
P2P网络的工作原理通常涉及节点发现、数据定位、资源管理、数据交换和网络维护等关键环节。它要求每个节点具有网络发现和路由的功能,以便有效地参与网络通信。
P2P网络通过其分布式特性,实现了数据和服务的高效共享,提供了优秀的容错性和抗压能力,成为当下很多互联网应用的基础架构。
2. yamux多路复用技术 2.1 yamux协议概述 2.1.1 多路复用的定义和作用
多路复用是一种通过单一物理通信链路传输多个逻辑数据流的技术。它使得网络资源得到了更加高效的利用,允许多个并发的通信会话共享物理连接,而不是每个会话都需要独立的物理链路。yamux作为多路复用技术的一种实现,专注于提高分布式系统中的数据传输效率,尤其是在P2P网络环境中。
2.1.2 yamux与其他多路复用技术的对比
yamux与传统的多路复用技术如HTTP/1.1的连接复用和HTTP/2的流复用相比,有着不同的设计哲学和优化目标。yamux特别针对长连接和低延迟场景进行了优化,使得在分布式系统中可以实现更好的吞吐率和更低的延迟。与TCP连接的短连接模型相比,yamux在保持连接开放状态的同时,能够以较低的开销处理多个并发请求,减少了连接建立和关闭的开销。
2.2 yamux的工作原理 2.2.1 yamux连接的建立和初始化
yamux通过一个初始的握手过程来建立连接。在这个过程中,客户端和服务器都会声明它们支持的流控制窗口大小、最大帧大小以及其他可选的参数。一旦握手完成,双方就可以创建和管理多个数据流了。每个流都有自己的状态信息,包括是否打开、关闭,以及当前的窗口大小等。
sequenceDiagram
    participant C as Client
    participant S as Server
    Note over C,S: 握手过程
    C->>S: 初始化帧
    S->>C: 响应帧(包括参数)
    Note over C,S: 连接建立后
    loop 数据流管理
        C->>S: 创建数据流请求
        S->>C: 确认响应
        C->>S: 数据传输
        S->>C: 数据传输
        C->>S: 流关闭请求
        S->>C: 关闭响应
    end
2.2.2 yamux帧结构和数据传输流程
yamux的帧结构定义了数据传输的基础单元。每个帧都有一个帧头,其中包含了类型、流标识符、序列号、标志位以及帧的长度等信息。数据传输流程通常遵循以下步骤:客户端或服务器准备数据,将数据封装成帧,然后通过yamux连接发送。接收方收到帧后,会根据帧头中的信息解码,并将数据重组为原始数据流。
2.3 yamux的优势与应用场景 2.3.1 yamux的性能优势
yamux的主要性能优势在于能够减少网络延迟、提高吞吐率以及优化资源利用。通过复用单个TCP连接,yamux减少了建立新连接所需的三次握手时间,并且因为保持了连接的持续性,使得连接的冷启动问题得到了缓解。此外,yamux还能够动态地管理流控制窗口,确保在不同的网络条件下,传输的效率是最优的。
2.3.2 yamux在P2P网络中的应用场景分析
在P2P网络中,节点之间的数据传输需求频繁且多变,yamux能够为这些场景提供稳定的性能保障。它能够处理大量并发的短小数据传输,这对于P2P文件共享、分布式计算和协作平台等应用来说是非常重要的。yamux的应用有助于提高数据同步的速度和可靠性,同时也能够降低网络拥塞的可能性,从而提升整个网络的可用性和扩展性。
在下一章节中,我们将深入探讨HTTP/2协议中的多路复用技术,并分析它与yamux技术的结合应用及优势。
3. 基于HTTP/2的Multiplexing概念 3.1 HTTP/2多路复用简介 3.1.1 HTTP/2协议的改进点
HTTP/2是HTTP/1.1协议的后继者,旨在解决其在传输性能方面的限制。与HTTP/1.1相比,HTTP/2有几个关键的改进点:
3.1.2 多路复用在HTTP/2中的实现机制
在HTTP/2中,多路复用主要通过以下机制实现:
3.2 HTTP/2流控制与优先级 3.2.1 流控制的原理及实现
流控制是确保网络资源合理利用的关键机制。在HTTP/2中,流控制有以下特点:
3.2.2 请求和响应优先级的管理
HTTP/2允许指定请求和响应的优先级:
3.3 HTTP/2与yamux技术的结合应用 3.3.1 技术整合的优势
将HTTP/2与yamux多路复用技术结合,可以发挥各自的优势,实现更高的性能和更有效的资源利用:
3.3.2 结合应用的案例分析
为了进一步了解结合应用的实际效果,可以分析以下案例:
通过上述内容,本章节深入探讨了基于HTTP/2的Multiplexing概念,并分析了它与yamux技术结合的优势和实际案例。这为开发者在构建高效的P2P网络应用时,提供了理论和实践相结合的参考。
4. 自定义协议设计与实现 4.1 自定义协议的必要性与设计原则 4.1.1 协议设计的考量因素
在分布式系统或者P2P网络中,自定义协议的设计是基础且关键的。设计时必须考虑的几个因素包括但不限于:
考虑到这些因素,自定义协议能够针对特定的应用场景进行优化,提供比标准化协议更高的性能和更灵活的扩展性。
4.1.2 自定义协议与标准化协议的比较
自定义协议和标准化协议各有优劣。标准化协议如HTTP、TCP/IP等被广泛使用并得到行业验证,但可能不适用于所有特殊场景。自定义协议可以对特定的业务需求做深度优化,但需要额外的开发和维护工作。以下是自定义协议与标准化协议的对比:
通过权衡这些因素,开发者可以根据实际需求选择最适合的协议。
4.2 协议结构与消息格式 4.2.1 数据包格式设计
设计数据包格式时,要考虑到以下方面:
以下是一个简单的数据包格式示例:
+-----------------------------------------------+
|  Protocol Version (1 byte) | Message Type (1 byte) |
+-----------------------------------------------+
|                     Message Length (2 bytes)                    |
+-----------------------------------------------+
|                     Checksum (4 bytes)                        |
+-----------------------------------------------+
|                             Message Body ...                 |
+-----------------------------------------------+
4.2.2 消息序列化与反序列化
序列化是指将数据结构或对象状态转换为可以存储或传输的格式的过程,反序列化则是将这个过程逆转。设计序列化机制时,需确保:
常见的序列化技术有JSON、Protocol Buffers、Apache Avro等。每种技术都有其特点,例如Protocol Buffers提供了紧凑的二进制格式。
4.3 协议的实现与测试 4.3.1 编码实现的细节
实现协议时,编码细节至关重要。常见的编码细节包括:
这里以Python语言为例,展示一个简单的TCP连接和消息分发实现:
import socket
def server():
    server_socket = socket.socket(socket.AF_INET, socket.SOCK_STREAM)
    server_socket.bind(('localhost', 12345))
    server_socket.listen(5)
    conn, addr = server_socket.accept()
    print('Connected by', addr)
    while True:
        data = conn.recv(1024).decode()
        if not data:
            break
        print('Received data:', data)
        # 分发消息到对应的处理函数
        dispatch_message(data)
    conn.close()
def dispatch_message(message):
    # 根据消息类型进行处理,这里简化处理逻辑
    if message.startswith('LOGIN'):
        process_login(message)
    elif message.startswith('QUERY'):
        process_query(message)
    # 其他消息类型的处理...
def process_login(message):
    # 登录处理逻辑...
    pass
def process_query(message):
    # 查询处理逻辑...
    pass
if __name__ == '__main__':
    server()
4.3.2 协议测试流程与方法
协议测试通常需要模拟多种网络条件和异常情况,常用的测试方法包括:
使用一些测试框架如Python的 unittest 可以帮助自动化测试过程。
通过这些细致的测试流程和方法,可以确保协议在各种条件下均能正确运行。
5. 节点发现机制
节点发现是构建一个高效、可靠的P2P网络的关键环节,它确保网络中的节点能够互相发现和连接。本章将深入探讨节点发现机制的原理、实现方式和优化策略。
5.1 节点发现机制概述 5.1.1 节点发现的重要性
节点发现机制是P2P网络中每个节点能够加入网络并与其他节点建立连接的基础。没有有效的节点发现机制,节点将无法获取网络中其他节点的信息,导致网络无法扩展或维护。它对于整个网络的稳定性和可扩展性起到了决定性作用。
5.1.2 常见的节点发现策略
在P2P网络中,有几种常见的节点发现策略,包括集中式发现、分布式哈希表(DHT)和基于广播的发现等。这些策略根据网络的规模、拓扑结构和应用场景的不同,各自有其优势和劣势。
5.2 具体实现方式 5.2.1 使用DHT实现节点发现
Distributed Hash Table(DHT) 是一种关键的节点发现技术,使得每个节点都能维护部分网络路由信息,实现节点的自我组织和发现。
实现细节
graph TD
    A[查询节点] -->|发起查找| B[DHT网络]
    B -->|路由信息| C[中间节点]
    C -->|返回结果| A
    B -->|存储信息| D[数据节点]
    D -->|资源信息| A
代码实现
以下是使用Python语言实现DHT的一个简单示例:
import hashlib
def hash_to_bucket(hash_value, bucket_count):
    return int(hash_value, 16) % bucket_count
def kademlia_dht(node_id, key, bucket_count=160):
    local_hash = hashlib.sha1(node_id).hexdigest()
    bucket_id = hash_to_bucket(local_hash, bucket_count)
    routing_table = {i: None for i in range(bucket_count)}
    routing_table[bucket_id] = node_id
    # 通过键值对定位到存储数据的节点
    # 省略实际的网络通信和路由更新过程
    # ...
    # 返回距离key最近的节点
    return routing_table[bucket_id]
# 假设节点ID为'node123',查找键值为'key123456'的节点
key = 'key123456'
node_id = 'node123'
closest_node = kademlia_dht(node_id, key)
print(f"Closest node to {key} is {closest_node}")
5.2.2 基于广播的节点发现
广播式节点发现是通过向网络中的所有节点发送信息来实现的,这种方式在小型网络中非常有效,但在大型网络中可能会导致网络拥塞。
实现细节
graph LR
    A[节点A] -->|广播| B[网络]
    C[节点B] -->|收到广播| D[节点A]
    D -->|发起连接| C
5.3 节点发现机制的优化策略 5.3.1 安全性增强措施
由于节点发现机制通常涉及网络通信,必须考虑安全性问题,防止恶意节点加入网络。
5.3.2 性能提升的方法
性能优化策略旨在提高节点发现效率,降低网络延迟和拥塞。
graph LR
    A[节点A] -->|请求| B[邻近节点缓存]
    B -->|快速响应| A
以上是本章关于节点发现机制的详尽内容,下一章节我们将深入探讨连接管理与流控制的相关知识。
6. 连接管理与流控制 6.1 连接管理策略 6.1.1 连接建立与维护机制
在P2P网络中,连接的建立和维护是保证网络稳定性和性能的关键。连接管理策略涵盖以下几个方面:
6.1.2 连接异常处理与恢复
当网络中的连接出现异常时,如超时、丢包或节点离线,需要有一套机制来处理这些问题,并尽可能恢复连接。主要策略包括:
6.2 流控制机制 6.2.1 流控制的基本原理
流控制是指在数据传输过程中,发送方和接收方之间的一种协调机制,用来防止发送方发送数据过快而使接收方来不及处理。基本原理包括:
6.2.2 实现自适应流控制的方法
实现自适应流控制的方法有很多,例如:
下面展示了一个简单的自适应流控制伪代码实现:
class AdaptiveFlowControl:
    def __init__(self, initial_window_size):
        self.window_size = initial_window_size
        self.cwnd = initial_window_size  # 拥塞窗口大小
        self.ssthresh = float('inf')     # 慢启动阈值
        self.lastAckTime = 0             # 最后确认接收时间
    def onAckReceived(self, ackNumber):
        # 更新发送窗口大小和拥塞控制参数
        self.cwnd += 1
        self.lastAckTime = currentTime()
    def sendData(self, data):
        # 如果窗口未满且在发送速率内,则发送数据
        if self.window_size > 0 and currentTime() - self.lastAckTime < 1:
            # 发送数据...
            pass
        else:
            # 等待ACK或调整窗口
            pass
    def onTimeout(self):
        # 超时处理,调整窗口和拥塞阈值
        self.ssthresh = self.cwnd // 2
        self.cwnd = 1
6.3 流控制在P2P网络中的应用 6.3.1 流控制在资源分配中的作用
在P2P网络中,流控制不仅仅是数据传输的优化,它还涉及到资源的有效分配:
6.3.2 流控制案例分析与实践
以BT(BitTorrent)网络为例,其采用的P2P协议中流控制是通过“Choking”和“Unchoking”机制实现的:
下面的表格展示了Choking机制在BitTorrent中的应用细节:
参数 说明
choking_algorithm
采用的阻塞算法(如公平算法、优化算法)
choking_period
阻塞和解除阻塞的周期
peer_interest
节点兴趣指标,取决于节点的上传速度
unchoke_candidates
被考虑解除阻塞的节点列表
最终,在实际应用中,通过以上案例分析,我们能将理论应用到实践中,使得流控制在P2P网络中发挥其应有的作用,确保网络的高效与稳定运行。
7. 数据加密与压缩优化
数据在P2P网络中传输时,安全性和效率是至关重要的两个方面。本章将深入探讨数据加密与压缩优化的技术原理和实践应用,以确保数据传输的安全性和高效性。
7.1 数据加密技术 7.1.1 数据加密的目的和重要性
数据加密旨在保护数据不被未授权的第三方截获和解读,它是保障数据传输安全的核心技术之一。加密过程涉及将明文转换为密文,只有持有正确密钥的用户才能解密并读取数据内容。在P2P网络中,数据加密尤其重要,因为网络节点的多样性和开放性增加了数据泄露的风险。
7.1.2 常用的数据加密算法
目前,有多种加密算法被广泛使用,包括但不限于:
7.2 数据压缩技术 7.2.1 数据压缩的基本原理和方法
数据压缩是通过消除数据中冗余的部分来减小数据大小的技术。压缩算法分为两大类:无损压缩和有损压缩。
7.2.2 压缩技术在P2P网络中的应用
在P2P网络中,数据压缩能有效减少节点间传输的数据量,提高网络传输效率。对于多媒体文件、大数据文件等,压缩后可以显著减少传输时间,提升用户体验。
7.3 数据加密与压缩的综合优化策略 7.3.1 优化策略的设计与实施
为了在保证数据安全的同时提升效率,需要设计综合的优化策略:
7.3.2 综合优化效果评估
实施上述优化策略后,可以通过以下指标来评估优化效果:
通过这些评估指标,可以验证综合优化策略是否在提升传输效率的同时,也保持了数据的安全性和完整性。
简介:本项目利用Python构建了一个P2P网络,重点在于使用yamux实现的多路复用技术和自定义协议的支持。P2P网络是一种去中心化架构,其中节点既是服务的消费者也是提供者,具有高稳定性和可扩展性。yamux多路复用协议提高了通信效率,减少连接开销,而自定义协议则增强了网络的适用性和灵活性。项目涵盖了节点发现、连接管理、自定义协议设计、数据交换和错误处理等关键部分,适合希望提升Python网络编程技能的开发者研究和实践。