

任职于某三甲医院,工学硕士,高级工程师,伦理委员,从事医疗信息化近10年,工作及研究方向:医疗大数据和药事信息化;发表论文9篇,SCI 2篇,统计源7篇。
一、问题与背景
1. 数据孤岛的典型表现与业务代价
以笔者所在医院为例,系统集成规模超过130个,并通过互联互通五级乙等、电子病历五级等测评。但系统越建越多,数据的“割裂感”却越来越强——这是国内绝大多数医疗机构的共同处境。
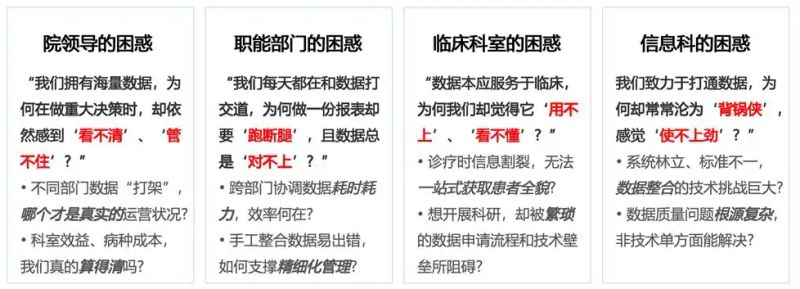
图1 四类角色之问:“我们是否正被数据所困”
院级层面,“拥有海量数据,为何做重大决策时依然看不清、管不住”;职能部门做报表要“跑断腿”、数据总是“对不上”;临床科室信息割裂、无法一站式获取患者全貌,想做科研却被申请流程和技术壁垒挡在门外;信息科打通数据,却常因质量问题沦为“背锅侠”。
1.1 临床视角:信息割裂,全景缺失
患者信息分散在HIS、LIS、PACS、EMR等数十个系统,医生需多系统来回切换,诊疗决策缺乏全景支撑;同一种肺炎可被写作“肺部感染”“支气管肺炎”“大叶性肺炎”,编码差异大,直接污染单病种质控数据。
1.2 管理视角:口径打架,算不清账
不同部门数据“打架”,科室效益、病种成本算不清;手工整合易出错,难以支撑精细化管理——根源是同一业务概念在不同系统、不同报表中各说各话。
1.3 科研视角:数据难用,成本高企
海量病例以非结构化文本沉淀,队列构建依赖人工筛选、纳入排除无留痕,真实世界研究的数据准备周期动辄以月计,研究可重复性差。
归根结底,孤岛的本质不是“系统多”,而是三个问题无解:医院有哪些数据、质量如何、价值几何?归谁管、谁来解释?——标准缺失、权责缺失、机制缺失。正如大数据领域中的经典比喻所言:“数据的真实价值如同冰山,可见的只是一角,绝大部分隐藏在水面之下”。
2. 数据基座上升为战略工程的背景
2.1 政策驱动:从数据要素到“人工智能+”的叠加共振
2022年12月《中共中央 国务院关于构建数据基础制度更好发挥数据要素作用的意见》(简称“数据二十条”)确立数据基础制度,2023年国家数据局成立,数据成为第五大生产要素。2025年8月至2026年6月,《国务院关于深入实施“人工智能+”行动的意见》(国发〔2025〕11号,2025年8月,国务院)、《关于推进行业高质量数据集建设行动的实施方案》(国数科基〔2026〕25号,2026年6月,国家数据局)、《关于促进和规范“人工智能+医疗卫生”应用发展的实施意见》(2025年11月,国家卫生健康委等五部门)、2026年“模数共振”行动(2026年4月,工业和信息化部、国家数据局)等政策密集出台,从顶层设计到行业落地形成闭环,主线一致:数据治理→模型研发→智能体应用→场景落地。
2.2 考核驱动:评审标准全面转向“用数据说话”
等级评审强调数据自动采集率与完整性,互联互通测评以标准化为前提,电子病历分级评价将数据质量列为核心考察项,国考指标大量依赖数据质量。2025年版三级医院评审标准取消现场检查,转向“日常行为、客观指标、定量评价”,错误数据超核查条款10%即一票否决——数据治理从“加分项”变成“生存项”。
2.3 技术驱动:数据与AI由“松耦合”走向“紧耦合”
医疗AI从“炫技”走向“落地”,数据与AI由松耦合转向紧耦合:数据为智能提供燃料,成为智能成效跃迁的胜负手。没有数据基座,AI只能停留在演示阶段。
二、数据基座的总体架构:一个可落地的治理框架
1. 数据基座的内涵与边界
1.1 参照DAMA与DCMM,而非“自创体系”
DAMA车轮图定义了数据架构、数据建模、数据安全、主数据、元数据、数据质量等11项管理职能,数据治理居中统领;DCMM从数据战略、数据治理、数据标准等9大能力域、33个能力项、576条能力指标进行分级评价。通俗地讲,数据治理就是为无序的原始数据制定统一“规则手册”,让数据从“散乱资源”变成可信赖、可高效利用的核心资产;数据基座,就是这套规则体系在医院的工程化落地形态。
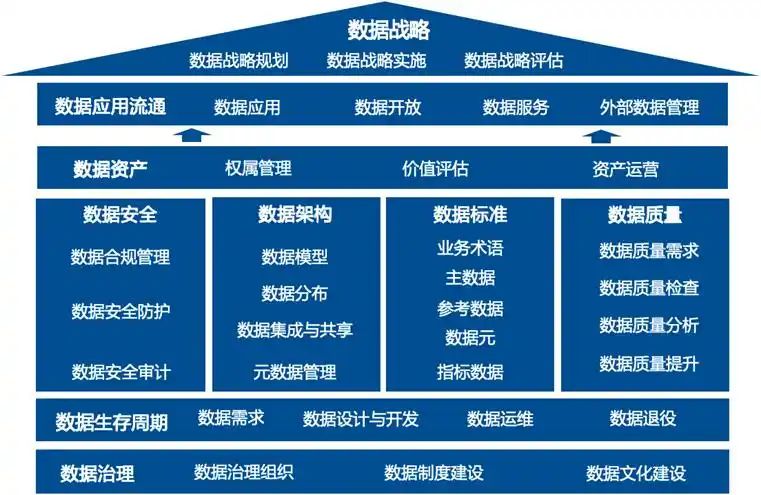
图2 DCMM2.0数据管理能力成熟度模型
1.2 “资源—资产—要素”的三阶跃迁
数据价值释放遵循三阶段规律:资源阶段,数据沉淀在业务系统;资产阶段,经治理盘活,可度量、可管理、可应用;要素阶段,数据驱动业务创新与增长。数据基座建设的本质,就是推动医院数据完成“资源→资产→要素”的跃迁。
2. “数治+数智”双轮驱动的体系架构
总体架构上,医院采用“数治+数智”双轮驱动模型,将数据治理与人工智能纳入同一框架。
2.1 底座层:“数治”让数据可信、可用、可靠、可控
底座层涵盖主数据标准化、统一数据标准、五维质量管控、全生命周期安全治理、统一指标体系和数据资产管理六大能力。基础设施坚持“五个一”:一朵云、一张网、一个数据中心、一套系统、一套标准,从根上消灭数据壁垒,让多院区、多业务数据“书同文、车同轨”。
2.2 引擎层:“数智”把数据转化为业务能力
引擎层面向临床诊疗、患者服务、运营管理、医学科研四大核心域,通过大模型、自然语言处理、计算机视觉和智能体技术,解决的不是“有没有数据”,而是“数据能否转化为价值”。
2.3 协同层:组织、制度与评价闭环
协同层由书记、院长牵头领导小组,下设数据治理、智慧医院、大数据与人工智能等专班,建立周调度、月通报、季考核机制。双轮的演进逻辑是“先治后智、以治促智、以智强治”——数治为数智提供燃料和规则,数智反过来倒逼治理深化。
三、数据基座建设的关键实践路径
1. 主数据治理:先让“人、财、物、事”说同一种语言
1.1 全景规划:把核心主数据纳入统一治理视野
医院将就诊人信息、科室、人员、床位、院区、医嘱项目、收费项目、检验指标、诊断、药品、设备等关键对象纳入统一治理视野,由数据治理归口部门统筹,人事、医务、药学、设备、财务等部门按“谁生产、谁负责”认领责任,建立起覆盖全院运行主干的主数据框架。
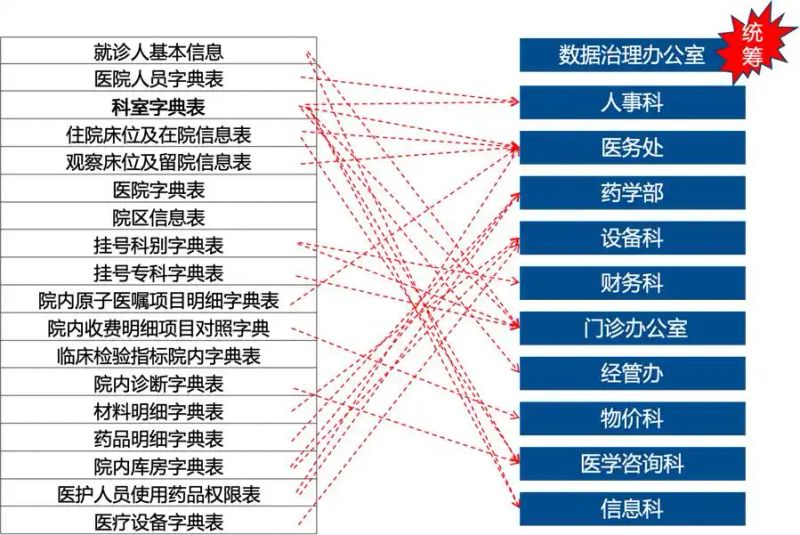
图3 主数据全景规划:全院核心主数据字典体系
1.2 一数一策:源头治理与映射治理的分工
科室字典历史包袱重,采用“映射治理”:完成1900余个科室标准化映射,规范化命名近1200个,清理长期未用科室300余个,科室管理从“临时清理”转向“持续治理”。人员字典采用“源头治理”,直接治理人事系统信息,职称、学历分别执行GB/T 8561、GB/T 4658等国标,在源头实现标准化。原则是:能在源头解决的绝不在下游打补丁,源头改不动的用映射兜底——“一数一策”。
2. 数据标准与指标体系:统一口径,消灭“各说各话”
2.1 “引用贯标+映射贯标”的标准化路径
没有统一标准,系统打通后数据仍可能“说的不是一回事”。实践中围绕业务术语、数据元、分类编码和指标口径建立标准体系,以“引用贯标”约束新建系统、“映射贯标”覆盖存量系统——既兼顾现实复杂性,又逐步收敛到统一语义。
2.2 统一指标库:4800余项指标的口径收敛
医院以三级医院评审为牵引,系统梳理省级评审标准、质控指标、统计年报、国家绩效监测、价格成本监测、高质量发展评价等政策来源,去重后形成4800余项指标的统一指标仓库,配套指标管理平台,实现统一定义、统一加工、统一出口。全量监测指标涉及上千个数据项、分散在数十个部门科室——不标准化、不日常化,评审就是“运动式救火”。
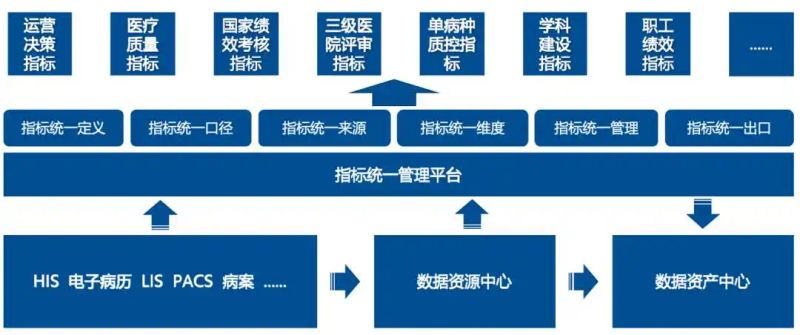
图4 统一指标体系:多政策来源指标梳理与指标仓库构成
3. 全生命周期数据质量管理:让数据“可信”
3.1 五维质量规则与逐项攻坚
围绕唯一性、完整性、合规性、同一性、时效性构建质量规则体系。以电子病历分级评价为例,如表1所示。
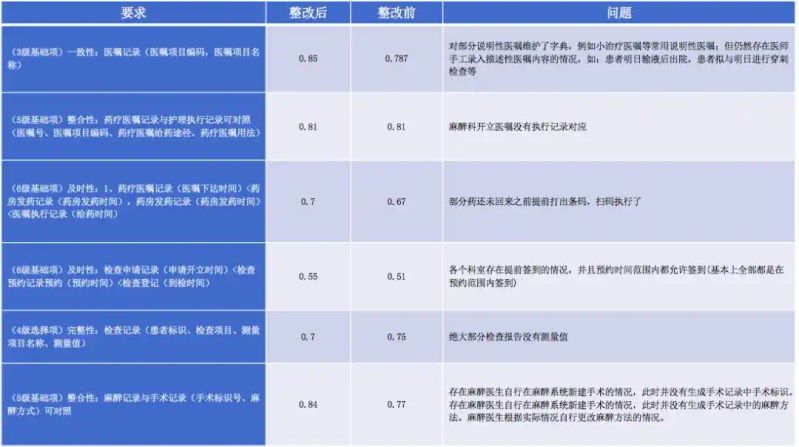
表1 数据质量整改示例(以电子病历分级评价为例)
3.2 从“事后检查”到“闭环运营”
质量管理关键不在查而在改。实践中形成“问题收集—根因分析—方案制定—整改实施—效果评估—持续运营”的闭环路径,辅以“四象限整改法”分类处置。评审质控链路上,先与责任科室路演确认数据抓取逻辑,大数据中心生产一级数据,科室加工生产二级数据并开展一级质控,职能部门开展二级质控——生产者、使用者、管理者各司其职,质量责任真正落地。
4. 数据安全与合规治理:守住底线才能释放价值
围绕采集、传输、存储、处理、共享、销毁全生命周期,落实数据分类分级、加密传输、脱敏使用、权限最小化和审计留痕;制度层面出台院级数据管理办法,按“谁产生、谁持有、谁管理、谁使用,谁负责”压实责任;面向AI训练等新场景,明确数据出域边界、伦理审查和去标识化要求,让数据“放得开、管得住”。
四、从基座到价值:数据驱动的典型场景与闭环
1. 专科高质量数据集:从“专病库”到“研究级数据资产”
高质量数据集是数据基座最直接的价值出口。以专病库为例,采用两级数据模型:通用数据库覆盖全院诊疗数据,专病数据库面向高血压、糖尿病、慢阻肺、肺结节等病种。数据链路上,源数据库原样迁移形成核证副本,经脱敏、清洗、结构化、标准化和OMOP(Observational Medical Outcomes Partnership,观察性医疗结果合作项目)通用数据模型映射形成标准研究数据,支撑队列研究等真实世界研究;术语层以SNOMED CT(Systematized Nomenclature of Medicine Clinical Terms,系统化临床医学术语集)为核心构建一体化中文医学术语体系。
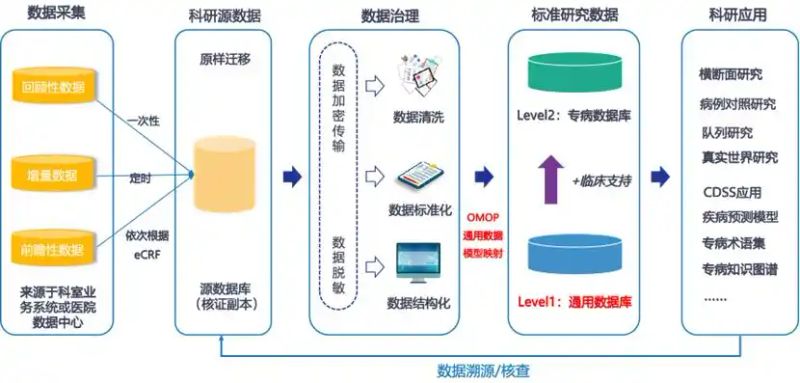
图5 专病库治理路径
非结构化数据最难啃也最有价值。基于深度网络的病历文本信息抽取模型可精确理解病历语义,配合可配置规则抽取框架,实现既往病史、烟酒史、家族史、主诉症状等要素的自动结构化,识别准确率与召回率均超过95%;变量定义与临床科室多轮评审——数据集质量由临床专家与数据团队共同背书。
2. 医疗AI落地:高质量数据是模型的胜负手
超声大模型的研发最能说明“数据决定智能上限”:4名高年资医师历时半年,完成14个脏器、110个病种、4.6万例病例、44万张超声图像的体系化标注(精细化勾画9万余张),在此底座上训练出87.7亿参数多模态模型,具备图像净化、病灶检测、多模态推理和结构化报告生成能力。另一条“业务定义AI”路径由超声科医生自研影像智能报告系统,报告生成缩短至秒级、关键信息零遗漏、任意步骤可人工接管。结论是:AI项目的实质是数据工程,高质量标注数据的组织能力,比算法选型更能决定成败。
3. 数据价值的持续运营:从“项目化”到“常态化”
数据基座建设没有终点。治理推进遵循三年三步走:第一阶段“平台筑基、优先两统”,建设数据资产平台、统筹主数据标准、统建指标体系;第二阶段“数据赋能、制度闭环”;第三阶段“常态管理、价值跃升”。机制上,通过“揭榜挂帅”面向全院征集AI创新项目,50余个申报、12个立项,让业务科室在拥抱AI的同时主动参与高质量数据集建设;配套专职人员、定期培训、科研门诊和每日使用推送,让数据服务“有人、有门、有账”。
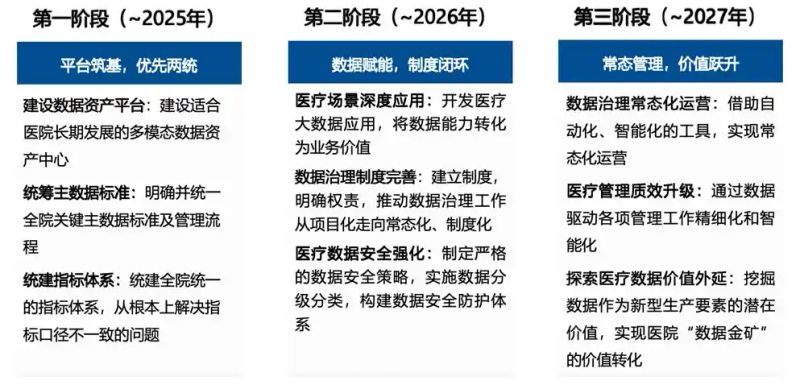
图6 数据治理三年规划
五、实施经验与行业思考
1. 关键成功要素
1.1 一把手工程与专班机制数据治理是全院工程而非部门工程。由党政主要领导牵头成立领导小组、设立多专班、建立周调度月通报季考核机制,才能突破“信息科推不动业务科室”的经典困局。
1.2 急用先行,快速见效
“天下难事,必作于易;天下大事,必作于细。”从科室字典、指标口径这类最痛、最具体的问题切入,三个月见成效,比一份完美的三年规划更能凝聚共识。
1.3 标准先行,整体规划、分步实施
先定规则再建系统,避免“边建边乱”;坚持3~5年演进路线的顶层设计,规划、平台、数据资产、应用场景、培训宣贯多线并进、分步交付。
2. 主要挑战与应对
一是历史数据治理周期长、成本高,分对象分优先级推进,源头与映射治理相结合;二是复合型人才短缺,通过数据管理员培训、医工交叉实验室和“业务定义AI”模式,让业务专家成为治理的同盟军;三是安全、伦理与责任边界尚待明晰,制度先行、分级分类、全程审计,宁可慢一点,不可“裸奔”。
3. 给行业的几点启示
第一,数据是资产,不是副产品——每一条日常产生的数据都是医院的宝贵资产,不是“顺便录一下”,而是要用心经营。第二,数据治理是管理问题,不是技术问题,归根结底是“谁来管、怎么管、管到什么程度”。第三,现在开始永远不晚:从统一科室名称、确定两个关键指标开始,就已经在做了。
从“数据孤岛”到“数据基座”,改变的不只是技术栈,更是医院的生产方式。未来医院之间的竞争,本质上是数据治理能力的竞争——基座筑牢之日,才是智能真正规模化绽放之时。